Twoja marka w LLM ma kształt i siłę
Raport z badań nad obecnością marek w odpowiedziach ChatGPT, Gemini, Perplexity, Copilot, AI Overviews i AI Mode
 Maciej Chmurkowski
Nie masz teraz czasu na czytanie całości?
Skopiuj raport jako markdown i wklej do ChatGPT, Claude'a albo dowolnego czatu AI. Zapytaj o to, co interesuje Cię najbardziej.
Co jest w środku
- Dwa badania
- Sześć platform
- Pięć metryk
- Wnioski i rekomendacje
0. Po co ten raport
Coraz większa część decyzji zakupowych zaczyna się dziś nie w wyszukiwarce, ale w oknie czatu AI. Użytkownik pyta "co wybrać", "co polecacie", "X czy Y" - i dostaje gotową odpowiedź z markami. Pytanie, czy jest wśród nich Twoja, przestało być ciekawostką, a stało się twardym tematem biznesowym.
Monitorujesz i analizujesz obecność swojej marki w odpowiedziach chatów LLM? Prawdopodobnie robisz to źle - albo mierzysz rzeczy, które mierzyć łatwo, zamiast tych, które mają znaczenie. Ten raport pokazuje, jak naprawdę zachowuje się obecność marek w odpowiedziach AI: jak bardzo jest losowa, co w tej losowości jest stabilne, co warto mierzyć, czego nie - i co z tym wszystkim robić.
Wszystkie liczby pochodzą z dwóch badań przeprowadzonych na danych LLM Monitora - systemu monitoringu widoczności marek w odpowiedziach AI, który budujemy w Senuto. Nie są to deklaracje ani ankiety, tylko setki tysięcy prawdziwych odpowiedzi AI, zebranych i przeanalizowanych w kontrolowanych warunkach.
Jak czytać ten raport: większość rozdziałów prowadzę od pytania, przez liczbę, do wniosku. Liczby bywają zaskakujące. Wnioski są praktyczne.
1. Dlaczego AI losuje
Deterministyczność to właściwość procesu, która gwarantuje, że dla tych samych danych wejściowych zawsze uzyskamy identyczny wynik. Zadajesz to samo pytanie, dostajesz tę samą odpowiedź.
I tu pierwsza, fundamentalna wiadomość tego raportu:
Modele LLM nie są deterministyczne.
Na identycznie zadane pytanie dostajemy skrajnie różne odpowiedzi. Różnią się nie tylko doborem słów (w około 70% tokenów), ale też formatem, przytaczanymi danymi - i, co nas interesuje najbardziej, markami, które się w nich pojawiają.
Skąd ta losowość? Cztery główne przyczyny:
Temperatura. Parametr określający, jak chętnie model sięga po mniej przewidywalne tokeny. Im wyższa, tym model bardziej "kreatywny". W chatach konsumenckich temperatura jest dobierana automatycznie - przy każdej rozmowie może być inna.
Podmiany modelu. ChatGPT potrafi obsłużyć to samo pytanie różnymi wersjami modelu, na przykład lżejszą wersją "mini". Dlaczego? Odpowiedź tkwi zapewne gdzieś bliżej kosztów infrastruktury. Efekt: to samo pytanie, inny silnik, inna odpowiedź.
System prompt. Ukryty zbiór reguł, które platforma dokleja do każdej rozmowy. Każdy system prompt jest utajniony i może zawierać instrukcje wpływające na kształt odpowiedzi. Zmienia się bez zapowiedzi.
Wyszukiwanie na żywo. Część platform (Perplexity, Copilot, AI Overviews, AI Mode, ChatGPT z włączonym wyszukiwaniem) buduje odpowiedź na wynikach wyszukiwania pobieranych w momencie pytania. Wyniki zmieniają się nieustannie - inne źródła, inna odpowiedź, inne marki. To losowość nie modelu, a internetu pod nim.
A do tego dalsze źródła losowości:
Kontekst rozmowyHistoria czatu, pamięć o użytkowniku i custom instructions doklejają się do pytania. To samo pytanie w dwóch rozmowach to technicznie dwa różne pytania.
Lokalizacja i personalizacjaPlatformy wiedzą, skąd pytasz i kim jesteś; odpowiedzi (zwłaszcza Google) bywają szyte pod użytkownika i region.
Testy A/B platformDostawcy stale eksperymentują na użytkownikach: część dostaje inną wersję zachowania czatu, zanim ktokolwiek to ogłosi.
Matematyka na GPUNawet przy temperaturze 0 wynik może się różnić, bo równoległe obliczenia i grupowanie zapytań na serwerach zmieniają kolejność działań zmiennoprzecinkowych.
Efekt końcowy? Widoczność marki w AI zmienia się tak często jak tabela ekstraklasy. Co kolejka przetasowanie - choć, jak zobaczysz dalej, mistrz na koniec i tak jest zwykle ten sam.
2. Jak to zmierzyliśmy
Baza danych LLM Monitora, na której pracowałem, to obecnie:
| Monitorowane prompty (pytania do AI) | ponad 100 tysięcy |
|---|---|
| Zebrane odpowiedzi AI | ponad milion |
| Platformy | 6: ChatGPT, Gemini, Perplexity, Copilot, AI Overviews, AI Mode |
Na tej bazie przeprowadziłem dwa badania: krótkoterminowe (ten sam dzień, pobrania co 20 minut) i długoterminowe (pełny miesiąc pomiarów według harmonogramu). Oba opisuję w kolejnych rozdziałach.
Zanim przejdziemy do liczb, trzy pojęcia, którymi będę się posługiwał - na przykładzie prawdziwej odpowiedzi:
- Wzmianka (brand mention) - marka pada w treści odpowiedzi. AI o Tobie mówi.
- Citation (cytowanie) - AI wskazuje konkretny adres strony jako źródło odpowiedzi.
- Search source - strona, którą platforma znalazła w wyszukiwaniu i na której oparła odpowiedź.
Wzmianka to widoczność marki. Citation i search source to widoczność Twoich treści jako źródeł. To dwa różne światy - i w raporcie mierzymy oba.
3. Badanie krótkoterminowe: ten sam dzień
Zamroziliśmy czas: te same pytania, zadawane raz za razem w ciągu jednego dnia.
| Parametry badania | Wartość |
|---|---|
| Prompty | 443, każdy zadany 10 razy (pobrania co ~20 minut) |
| Zebrane odpowiedzi | 18 920 |
| Przeanalizowane wzmianki marek | 66,8 tys. |
| Platformy | 6 |
Twoja marka jest nr 1 w odpowiedzi AI. Zadajesz to samo pytanie 20 minut później. Jaka szansa, że utrzyma pozycję?
Rzut monetą z lekką przewagą. Przypominam: to badanie krótkoterminowe - pobranie po pobraniu, w ciągu jednej doby, bez żadnych zmian na rynku.
Pełna podróż marki z pozycji nr 1 między dwiema kolejnymi odpowiedziami:
| Co się dzieje z marką nr 1 | % przypadków |
|---|---|
| Zostaje na pozycji 1 | 56,5% |
| Spada na pozycje 2-3 | 12,2% |
| Spada na pozycje 4-5 | 3,0% |
| Spada na pozycje 6+ | 1,3% |
| Znika z odpowiedzi całkowicie | 27,0% |
Zwróć uwagę na ostatni wiersz: niemal co trzecia marka z pierwszego miejsca nie spada niżej - ona po prostu znika z odpowiedzi. AI częściej markę wyrzuca, niż przesuwa w dół.
Jak często AI zmienia kolejność marek między dwiema identycznymi odpowiedziami?
W połowie przypadków dochodzi do przetasowania. A skala zależy od platformy - od 29% zmian na Perplexity po 67% na Gemini:
| Platforma | Pary odpowiedzi ze zmianą kolejności |
|---|---|
| Perplexity | 29% |
| Copilot | 46% |
| ChatGPT | 52% |
| Google AI Overviews | 61% |
| AI Mode | 63% |
| Gemini | 67% |
Im wyżej marka jest wymieniona, tym rzadziej wypada
| Pozycja marki | Marka zostaje w odpowiedzi | Wypada całkiem |
|---|---|---|
| top 1 | 73% | 27% |
| top 2-3 | 64% | 36% |
| top 4-7 | 51% | 49% |
| top 8-10 | 40% | 61% |
Marki z górnych pozycji utrzymują się najdłużej. Ale uwaga - to nie pozycja je chroni. To siła marki stawia je wysoko i jednocześnie trzyma w odpowiedziach. Do tego mechanizmu wrócę w rozdziale o chaosie kontrolowanym.
Małe podsumowanie, żeby się nie pogubić - to dwie różne liczby:
"Czy marka z top 1 będzie w ogóle w odpowiedzi?" - 73%
"Czy utrzyma pozycję nr 1?" - 56,5%
Które platformy trzymają marki, a które szaleją?
W badaniu krótkoterminowym najdłużej trzymają marki Perplexity (84% powrotu z pozycji 1) i modele Google - AI Mode i AI Overviews (po 81%). W ogonie ChatGPT (66%) i Gemini (65%).
| Platforma | Marka z pozycji 1 wraca w następnym pobraniu |
|---|---|
| Perplexity | 84% |
| AI Mode | 81% |
| Google AI Overviews | 81% |
| Copilot | 76% |
| ChatGPT | 66% |
| Gemini | 65% |
Zapamiętaj ten ranking - w badaniu miesięcznym czeka nas niespodzianka.
4. Badanie długoterminowe: miesiąc
Tym razem nie zamrażaliśmy czasu - puściliśmy go. Pełny miesiąc regularnych pomiarów, wszyscy klienci LLM Monitora.
| Parametry badania | Wartość |
|---|---|
| Czas | 30 dni, pomiary wg harmonogramu (zwykle co ~7 dni) |
| Prompty | 22 313 |
| Zebrane odpowiedzi | 388 tys. |
| Przeanalizowane wzmianki marek | 1,35 mln |
| Unikalne marki w odpowiedziach | 141 170 |
| Platformy | 6 |
Ile marek widocznych dziś w AI będzie tam nadal za tydzień?
Dwie trzecie marek znika z odpowiedzi w ciągu tygodnia. Widoczność w AI to nie stan posiadania - to abonament odnawiany przy każdym losowaniu.
Marka dopiero co weszła na pozycję 1. Ile procent przetrwa dwa tygodnie?
Świeże wejścia są kruche. Dla porównania: marki obecne na pozycji 1 "od zawsze" wracają w 74%. AI ma pamięć nawyków, nie newsów. To kolejny dowód na to, że o obecności decyduje zbudowana siła marki, nie pojedynczy sukces.
Marki jednorazowe
| Ile razy marka padła w AI w ciągu miesiąca | Marek | % wszystkich |
|---|---|---|
| Dokładnie 1 raz | 85 423 | 60,5% |
| 1-5 razy | 123 409 | 87,4% |
| 100+ razy | 1 220 | 0,9% |
Ponad połowa wszystkich marek padła w AI dokładnie raz przez cały miesiąc - i nigdy więcej. 87% marek to statyści z maksymalnie pięcioma wzmiankami. Prawdziwa rozmowa toczy się wśród 1 220 marek - to niecały 1%.
Platformy w czasie: wielkie odwrócenie
Pamiętasz ranking z badania dziennego? W skali tygodni odwraca się o 180 stopni. Perplexity - najstabilniejsza w ciągu dnia - między tygodniami wymienia marki najmocniej ze wszystkich. Gemini odwrotnie: losuje kolejność w ciągu dnia, ale pulę marek trzyma najlepiej.
| Platforma | Marka wraca w następnym tygodniu (obecność) |
|---|---|
| Google AI Overviews | 47% |
| AI Mode | 43% |
| Gemini | 42% |
| ChatGPT | 40% |
| Copilot | 31% |
| Perplexity | 28% |
Intuicja: Perplexity żyje świeżym indeksem wyszukiwania (co tydzień inne źródła), Gemini generuje bardziej "z pamięci" (stabilna pula, chaotyczna kolejność). Wniosek praktyczny: ocena stabilności platformy zależy od skali czasu, w której patrzysz.
5. Citations i search sources
A jak w badaniu miesięcznym wypadają cytowane adresy i źródła z wyszukiwania?
| Źródło | Poziom | Wraca za tydzień | Jednorazowe (1 raz w miesiącu) |
|---|---|---|---|
| Citations | URL | 21% | 75% |
| Citations | Domena | 35% | 48% |
| Search sources | URL | 24% | 73% |
| Search sources | Domena | 36% | 51% |
Konkretny artykuł to w AI towar jednorazowy - trzy czwarte linków, które AI cytuje, pojawia się dokładnie raz i nigdy więcej. Domena jest około 1,7x trwalsza - ale nawet ona wraca tylko w co trzecim przebiegu, a połowa domen pojawia się raz na miesiąc.
Dla strategii treści oznacza to dwie rzeczy: pojedynczy "cytowany artykuł" to chwilowy sukces, a stabilną pozycję w źródłach buduje się na poziomie domeny.
6. Intencje
Tu zatrzymam się na dłużej, bo to jedna z najważniejszych rzeczy w tym raporcie.
Odejdźmy od przestarzałych intencji zapożyczonych z klasycznego SEO. W monitoringu AI używam sześciu intencji, które są ściśle powiązane z formatem odpowiedzi AI:
| Intencja | Pytanie użytkownika |
|---|---|
| exploration | "co wybrać do X", eksploracja tematu |
| recommendation | "co polecacie", prośba o rekomendację |
| definition | "co to jest", pytanie o wyjaśnienie |
| comparison | "X czy Y", porównanie opcji |
| validation | "czy X jest dobre", walidacja wyboru |
| ranking | "top 10...", prośba o zestawienie |
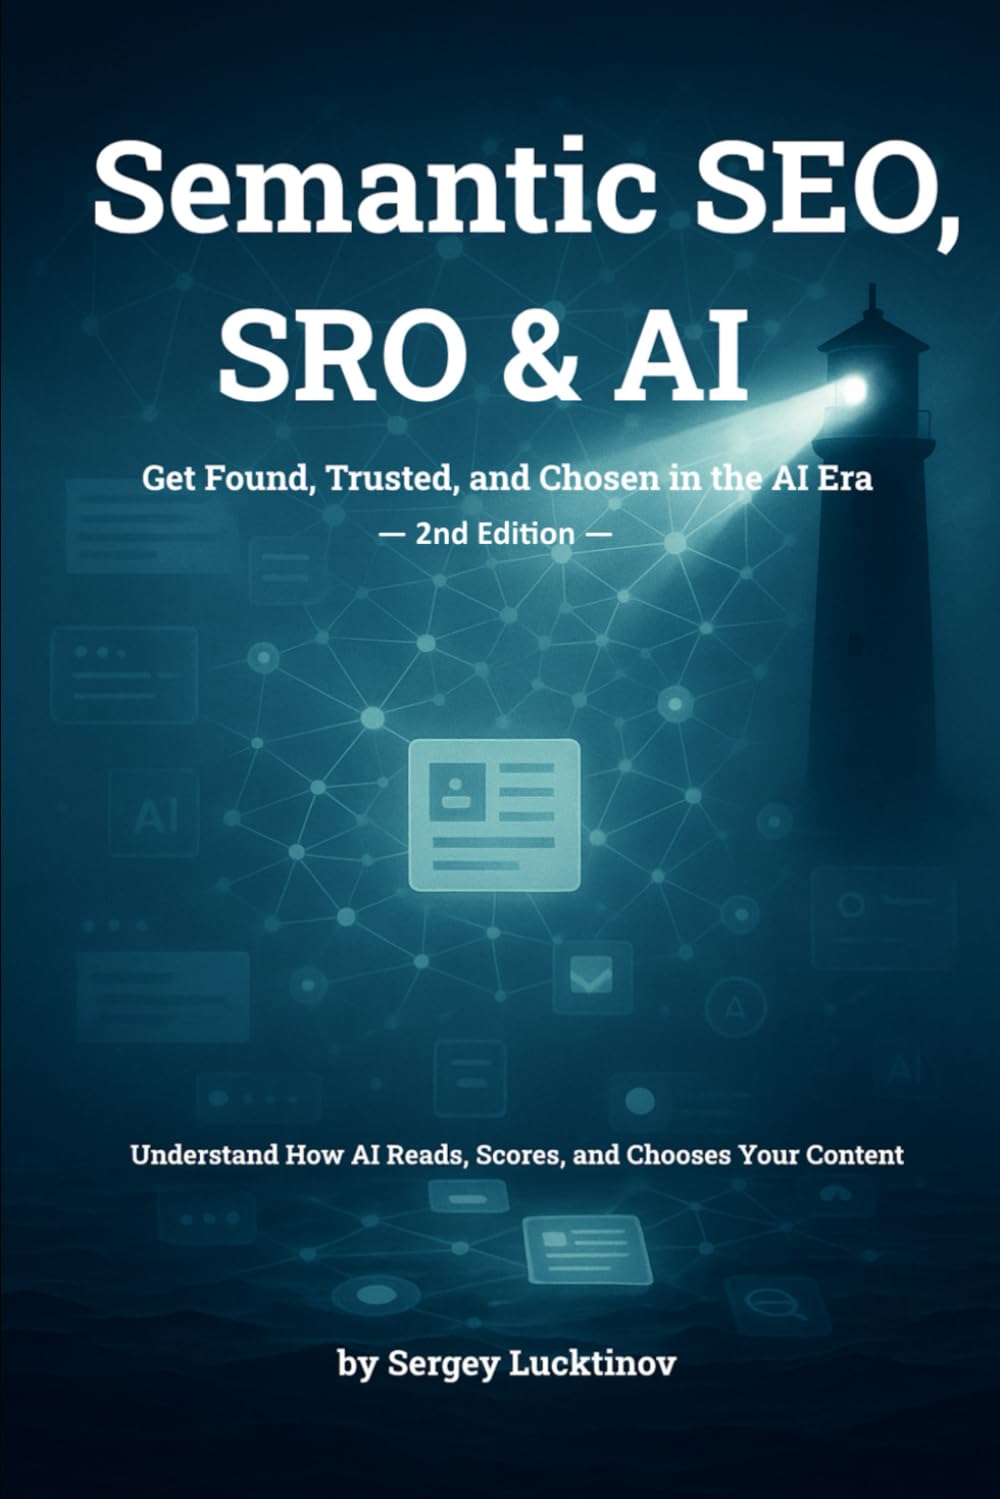
Ten podział zapożyczyłem z książki Sergeya Lucktinova "Semantic SEO, SRO & AI - Get Found, Trusted, and Chosen in the AI Era". Jeśli interesujesz się widocznością w AI - lektura obowiązkowa. Zmienia wiele perspektyw.
Utrzymanie marki zależy od intencji
| Intencja | Marka utrzymuje się tydzień do tygodnia |
|---|---|
| comparison | 53% |
| validation | 46% |
| ranking | 44% |
| definition | 43% |
| recommendation | 34% |
| exploration | 33% |
W pytaniach porównawczych i walidacyjnych AI "trzyma zdanie" - raz wpuszczona marka siedzi, zapewne przez samą logikę takiej odpowiedzi. W eksploracji i prośbach o polecenia - a to zdecydowana większość wolumenu pytań - AI losuje najmocniej.
Szerokość obecności w intencjach
Sprawdziłem też, jak wygląda stabilność marki obecnej w jednej intencji kontra obecnej w pięciu i sześciu:
| Marka obecna w... | Wraca za tydzień |
|---|---|
| 1 intencji | 33% |
| 5-6 intencjach | 99% |
Dane mówią same za siebie. Jedno ważne dopowiedzenie: ta różnica idzie w parze z dużą liczbą wzmianek rozłożonych w tych intencjach. To skala obecności niesie trwałość - a szeroka obecność w intencjach jest jej najprostszą drogą i najlepszym wskaźnikiem.
7. Sentyment: metryka, która obiecuje więcej, niż daje
Jaki procent odpowiedzi ma negatywny sentyment?
Można by powiedzieć, że negatywny sentyment nie istnieje. A jeśli spojrzymy głębiej - rozkład na wszystkich platformach wygląda niemal identycznie:
| Platforma | Pozytywny | Neutralny | Negatywny |
|---|---|---|---|
| ChatGPT | 64,7% | 35,0% | 0,3% |
| AI Mode | 64,7% | 35,2% | 0,2% |
| Copilot | 63,6% | 35,6% | 0,8% |
| Google AI Overviews | 62,5% | 37,3% | 0,1% |
| Gemini | 59,9% | 39,9% | 0,2% |
| Perplexity | 55,1% | 44,5% | 0,4% |
| Razem | 61,7% | 37,9% | 0,5% |
Granica między sentymentem pozytywnym a neutralnym jest cienka i umowna, a proporcje wszędzie te same - niezależnie od marki i platformy. To nie jest metryka opinii o Twojej marce. To metryka uprzejmości chatbotów.
Modele językowe nie opiniują marek. One je opisują.
W praktyce to sentyment "pozytywny" nie istnieje jako sygnał - jest domyślnym tonem modeli. Wartość ma wyłącznie ten minimalny negatyw: on faktycznie odzwierciedla negatywne opinie, które model znalazł w źródłach. I tylko jego warto monitorować - jako system wczesnego ostrzegania, nie jako KPI.
8. Jak mierzyć obecność marki (i jak jej nie mierzyć)
Dotrwaliśmy do metryk. Pięć, które mają sens - i dwie, które mają go znacznie mniej.
Share of Voice
Najpopularniejsza metryka każdego systemu monitoringu. Wyobraź sobie tort wszystkich wzmianek o markach w Twojej kategorii - Share of Voice to kawałek, który należy do Ciebie. Mówi o Twoim miejscu na tle całego rynku, nie tylko śledzonych konkurentów.
Brand Mentions Visibility
Procent odpowiedzi AI, w których pada Twoja marka. Stabilna w czasie i dobra jako puls - ale trochę ułomna: mówi tylko, czy marka istnieje w odpowiedzi. Nie mówi, czy jest rekomendowana, polecana jako pierwsza, czy tylko stoi daleko w tłumie.
First Choice
Jak często AI wskazuje Twoją markę jako swój pierwszy wybór. I tu najczęstsze nieporozumienie: first choice to nie pozycja w odpowiedzi.
Model może najpierw wymienić wszystkie marki, a dopiero potem szerzej je opisać i wskazać zwycięzcę. First choice wynika z kontekstu całej odpowiedzi - z tego, kogo model faktycznie stawia jako najlepszy wybór - a nie z kolejności wymieniania.
Recommendation Rate
Czy AI Twoją markę poleca, czy tylko o niej wspomina. To zupełnie inna jakość obecności niż sama wzmianka.
Recommendation Strength
A skoro poleca - to jak mocno? Od letniej wzmianki "warto też rozważyć" po jednoznaczne "to najlepszy wybór". Siła rekomendacji domyka obraz.
Dlaczego akurat te metryki? Bo wiążą się z trwałością
Te metryki mają bezpośrednie powiązanie z powtarzalnością występowania marki. Z naszego badania dziennego:
| Stan marki w odpowiedzi | Marka wraca w kolejnym pobraniu |
|---|---|
| Tylko wymieniona | 49% |
| Polecona | 59% |
| Pierwszy wybór AI | 71% |
Im głębiej marka siedzi w odpowiedzi, tym rzadziej z niej wypada. Dlatego mierzymy nie tylko czy modele o Tobie mówią, ale jak to robią.
Jak NIE mierzyć
Pozycja marki w odpowiedzi. Omawiana wcześniej i owiana złą sławą: zmienia się w połowie kolejnych odpowiedzi, a jej "utrzymanie" to w większości objaw siły marki, nie samej pozycji. Pojedynczy odczyt pozycji to fotografia ruletki.
Pozycja jednej marki w jednym pytaniu, 10 pobrań jednej doby
Senuto, Gemini, pytanie o narzędzia analityczne SEO
Od pozycji 1 do 9 w dwadzieścia minut - bez żadnej zmiany na rynku.
Sentyment. Jak w rozdziale 7: rozkład jest wszędzie taki sam, pozytyw to domyślna uprzejmość modeli. Nadaje się na alarm (negatyw), nie na KPI.
Wynik sentymentu marki w 10 pobraniach tej samej doby
Nodeshub, te same pytania
Huśtawka o 14 punktów bez jednego nowego zdarzenia wokół marki.
9. Chaos kontrolowany
Czas wyjaśnić paradoks, który przewija się przez cały raport.
Dlaczego metryki mierzone w czasie pokazują stabilność, skoro marki w pojedynczych odpowiedziach losują się tak mocno?
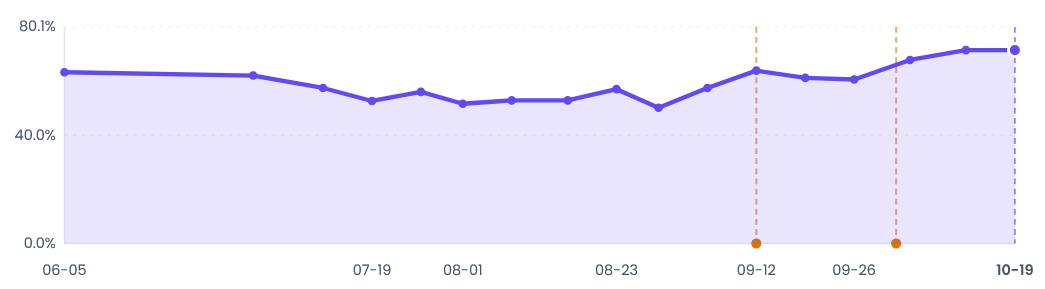
Spójrz na wykres Brand Mentions Visibility naszej marki (Senuto): poziom stabilny, wahania w granicach kilku punktów procentowych, a widoczne wzrosty to nie szum - to efekt prowadzonych działań i włączenia do monitoringu dwóch nowych platform.
Nazywam to chaosem kontrolowanym:
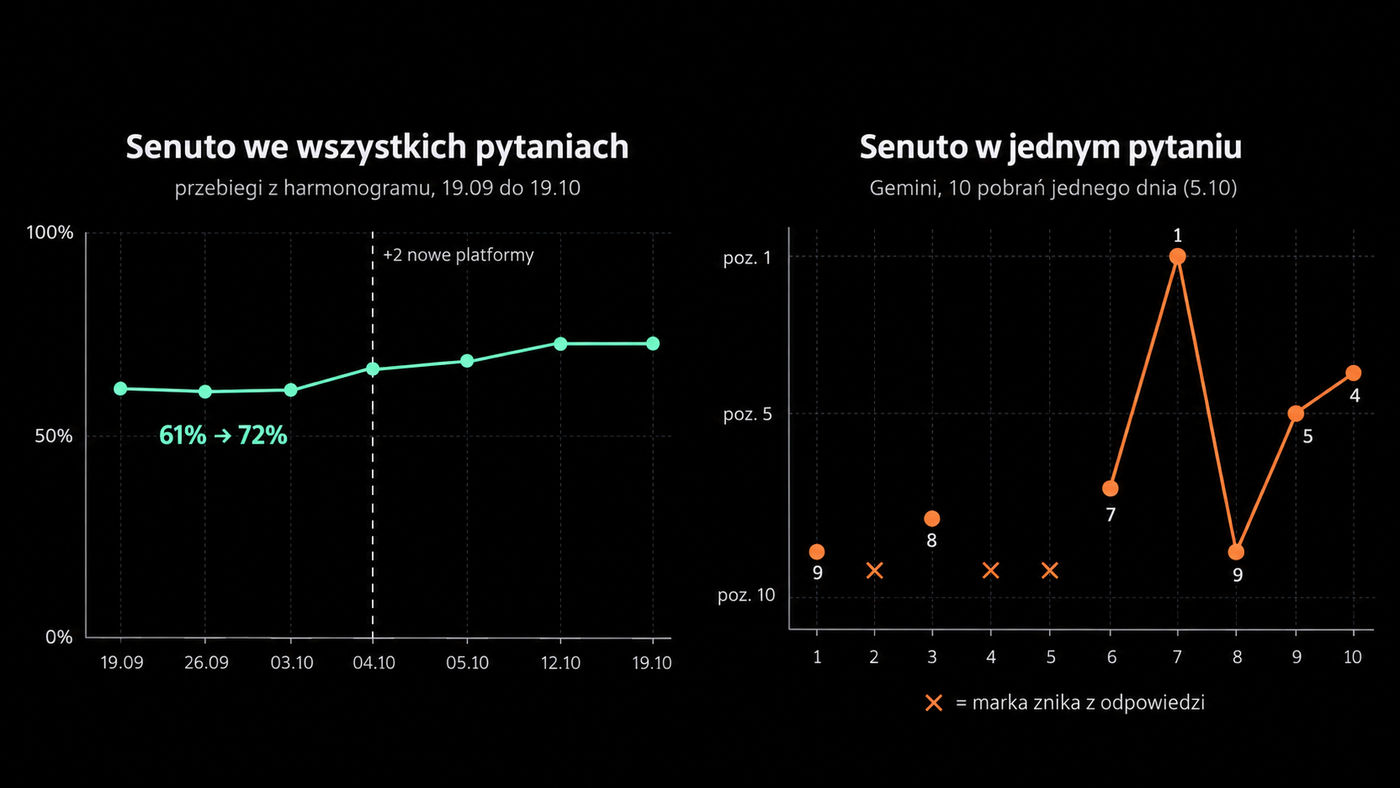
W każdym pobraniu marka wypada z części pytań i równocześnie wchodzi w inne - saldo blisko zera. W naszym badaniu dziennym Senuto zniknęło łącznie z 218 pytań i pojawiło się w 220 innych. Saldo: +2. Poziom: ~70%, jak skała - choć pod spodem co pobranie wymieniało się kilkanaście procent odpowiedzi.
siła marki ≈ widoczność
W szerokim portfelu pytań marka ma stabilne prawdopodobieństwo wylosowania - tyle samo pytań traci, ile odzyskuje. Nie kontrolujesz pojedynczego losowania. Kontrolujesz prawdopodobieństwo, z jakim zostaniesz wylosowany. A to prawdopodobieństwo zmienia tylko realna praca nad marką, nie ruletka pojedynczych odpowiedzi.
Z tego mechanizmu wynikają dwa praktyczne warunki dobrego pomiaru:
- Im więcej promptów monitorujesz, tym dokładniejszy jest pomiar. Prawo wielkich liczb działa na Twoją korzyść: mały portfel pytań faluje, duży pokazuje prawdziwy poziom. Nie zobaczysz tego mechanizmu, mierząc 20 promptów.
- Rozłóż prompty równo w intencjach, etapach lejka sprzedażowego i podkategoriach tematycznych. Nie zobaczysz całości, mierząc tylko jedną intencję, kategorię czy tematykę - różne typy pytań losują z różną siłą i pokrywają inną część ścieżki klienta.
10. Nie tylko metryki: mapa tematów i luki do zajęcia
Tu dochodzimy do rzeczy, która z pomiaru robi strategię. Bo monitoring, który kończy się na metrykach, to dopiero połowa roboty.
Wyobraź sobie, że do każdej odpowiedzi AI możesz dodać klasyfikację tematów, których ta odpowiedź dotyczy - jak tagi. Nagle przestajesz patrzeć na jedną zbiorczą liczbę i zaczynasz widzieć mapę: w których tematach Twoja marka żyje w odpowiedziach AI, a w których nie istnieje.
I teraz najważniejsze. Na tę mapę nakładamy konkurencję:
Gdzie AI nas zna, a gdzie nas nie ma
W tych tematach AI nas zna
W tych nas nie ma
Po lewej tematy, w których AI zna Twoją markę. Po prawej - tematy, w których Ciebie nie ma, a konkurenci są. I ta prawa kolumna jest najcenniejszym elementem całego monitoringu, bo to nie jest raport. To jest lista zadań.
Nie mierz dla samego mierzenia. Uzupełniaj luki. Każdy temat, w którym AI cytuje konkurentów, a Ciebie pomija, to gotowy brief: artykuł do napisania, wzmianka do zdobycia, obecność do zbudowania. Metryki mówią, jak jest. Luki mówią, co robić. Jeśli z całego raportu masz zapamiętać jedno działanie, to właśnie to: regularnie przeglądaj tematy, w których przegrywasz, i zamieniaj je w plan contentowy. Marka, która systematycznie domyka luki tematyczne, podnosi swoje prawdopodobieństwo wylosowania w setkach pytań naraz - zanim konkurencja zauważy, że w ogóle była tam sama.
11. Analiza konkurencji: punkt odniesienia zmienia perspektywę
Skoro mówimy o konkurencji - warto ją wykorzystać jeszcze raz, do ponownego spojrzenia na własne liczby.
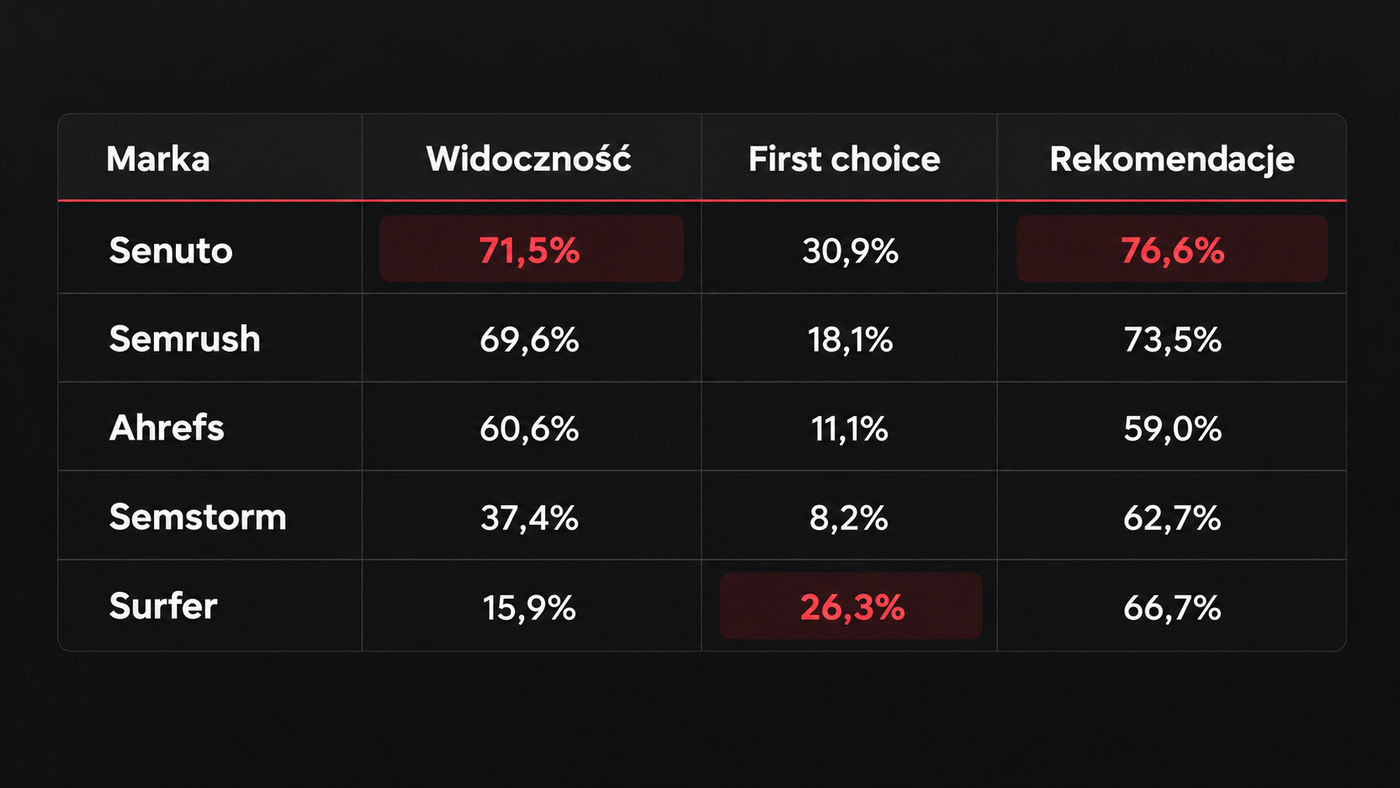
Porównanie do konkurencji to jak zejście na ziemię albo wejście do raju. First choice, który wydawał Ci się niski, w porównaniu z konkurencją może okazać się biletem do nieba - bo w AI wszyscy gramy na tych samych pytaniach i w tych samych odpowiedziach. To najuczciwszy benchmark, jaki istnieje: ta sama odpowiedź ocenia wszystkich jednocześnie.
Pokazując metryki klientom czy zarządowi, zawsze dawaj porównanie z największymi konkurentami. Liczba bez tła to wróżenie.
Dwa kierunki, w których analiza konkurencji zamienia się w działanie:
Najczęściej cytowane domeny tam, gdzie Cię nie ma.
Może się okazać, że w części z nich możesz po prostu kupić wzmiankę - i obserwację łatwo zamienisz w akcję.
Konkretne artykuły z citations i search sources.
To kopalnia wiedzy o treściach i formatach, które AI faktycznie cytuje - i jednocześnie gotowa lista do outreachu.
12. Do brzegu: kształt i siła
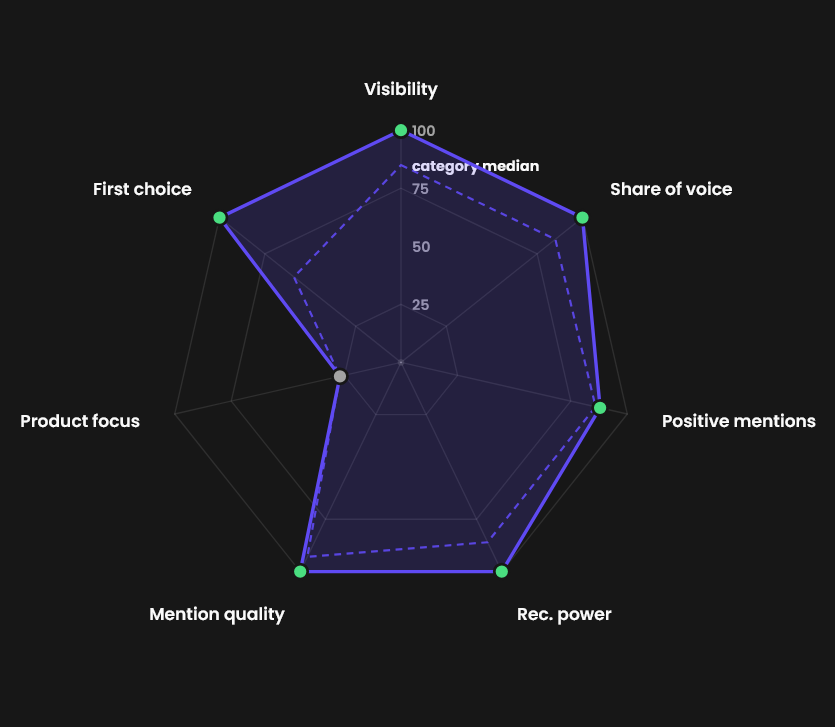
Twoja marka w LLM ma konkretny, mierzalny kształt. Ten kształt ma siłę i kierunek - i mimo niedeterministyczności modeli jedno i drugie da się zmierzyć. Każde ramię tego kształtu to jedna z metryk z tego raportu, a punkt odniesienia wyznacza mediana Twojej kategorii.
I ostatnia myśl, która spina wszystko:
NIE KONTROLUJESZ POJEDYNCZEGO WYNIKU.
BUDUJESZ PRZEWAGĘ, KTÓRA ZWIĘKSZA TWOJĄ SZANSĘ, ŻE AI WYBIERZE TWOJĄ MARKĘ.
Pojedyncza odpowiedź to losowanie. Ale waga monety, którą AI rzuca, jest w Twoich rękach: skala obecności, głębokość rekomendacji, pokrycie tematów i intencji, obecność w cytowanych źródłach. Mierz to, co mierzalne - i systematycznie dokładaj do wagi.
Pierwsza pomoc
Na koniec coś zupełnie innego. Ta wiedza nie podniesie widoczności żadnej marki, ale może kiedyś uratować komuś życie. Pierwszej pomocy powinni uczyć w szkołach - skoro nie uczą, korzystam z każdej okazji, żeby ją przypominać. Ten raport nie będzie wyjątkiem. Trzy rzeczy warte zapamiętania; dwie minuty czytania.
1. AED i aplikacja Ratownik
Łańcuch przeżycia
Rozpoznanie i wezwanie pomocy
sprawdź przytomność i oddech, dzwoń 112
Wczesna resuscytacja (RKO)
30 uciśnięć na 2 oddechy, tempo 100-120/min
Wczesna defibrylacja (AED)
jak najszybciej podłącz; AED prowadzi głosowo
Opieka poresuscytacyjna
przekazanie zespołowi ratownictwa
Im szybciej zadziałają pierwsze trzy ogniwa, tym większa szansa przeżycia - z każdą minutą bez defibrylacji spada ona o około 10%.
Przy nagłym zatrzymaniu krążenia liczą się pierwsze minuty, a potem każda sekunda. Schemat jest prosty: sprawdź przytomność i oddech, wezwij pomoc (112), rozpocznij resuscytację - 30 uciśnięć klatki piersiowej na 2 oddechy, w tempie 100-120 uciśnięć na minutę - i jak najszybciej użyj AED (automatycznego defibrylatora). AED prowadzi Cię głosowo krok po kroku, nie da się nim nikomu zaszkodzić.
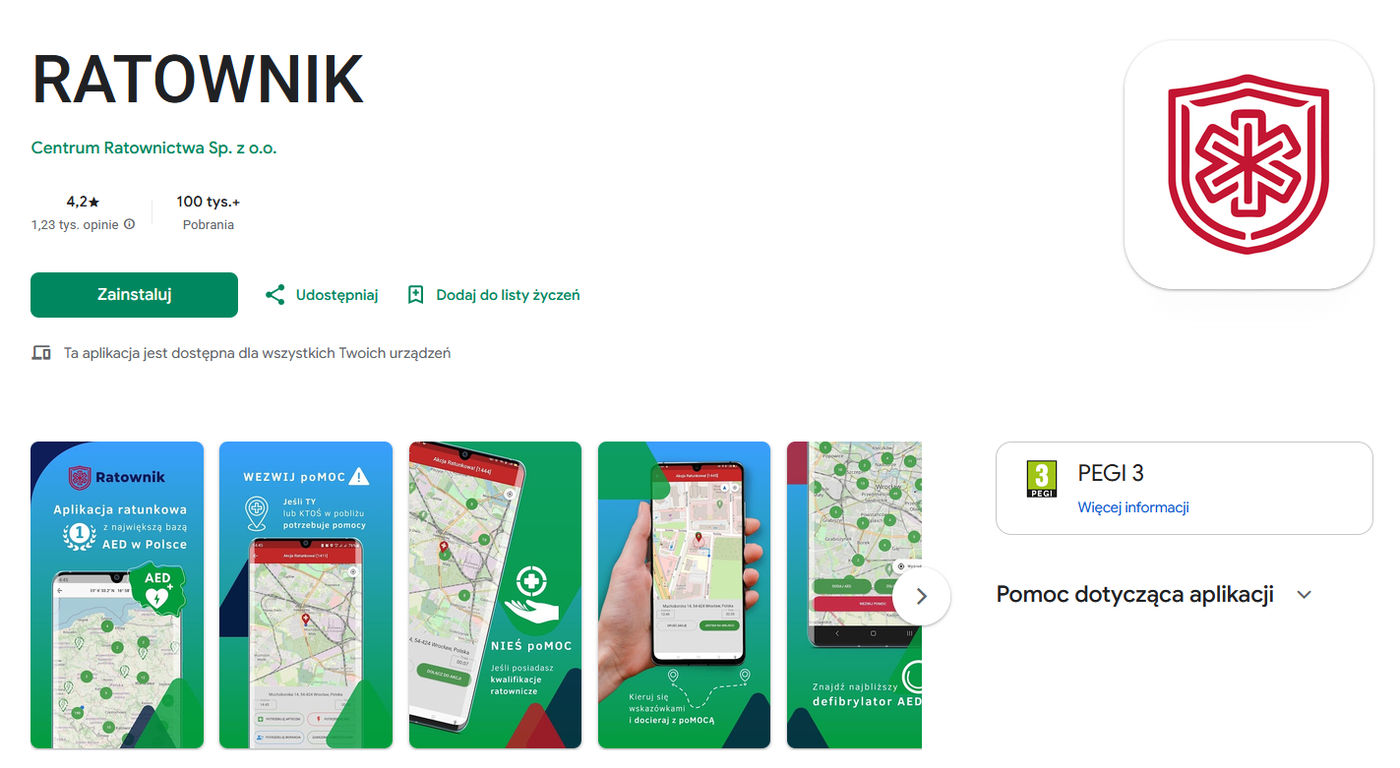
Gdzie jest najbliższy defibrylator? Ja sprawdzam to w każdym budynku, w którym spędzam więcej czasu. Ty zainstaluj aplikację Ratownik - ma mapę AED w Polsce. Zrób to dziś; w sytuacji, w której będzie potrzebna, nie będzie czasu na szukanie w sklepie z aplikacjami.
2. Sprężynowy zbijak do szyb
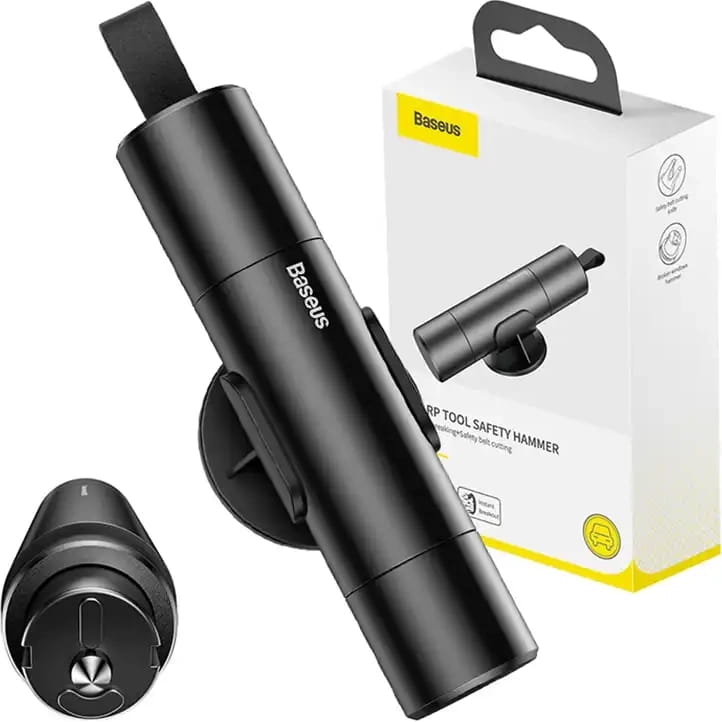
Wypadek samochodowy w większości przypadków powoduje zakleszczenie drzwi. Auto może też zacząć się palić, a elektryka - w tym sterowanie szybami - często odmawia posłuszeństwa. Sprężynowy zbijak przykładasz do rogu szyby bocznej (przednia jest laminowana i nie pęknie) i naciskasz - sprężyna robi resztę. Dobry zbijak ma też przecinak do pasów, bo napięty pas po wypadku bywa nie do odpięcia.
Warunek jeden: musi być w środku, w zasięgu ręki kierowcy - nie w bagażniku. Jest mały, elegancki i kosztuje tyle co dwie pizze. Must have.
3. Staza taktyczna
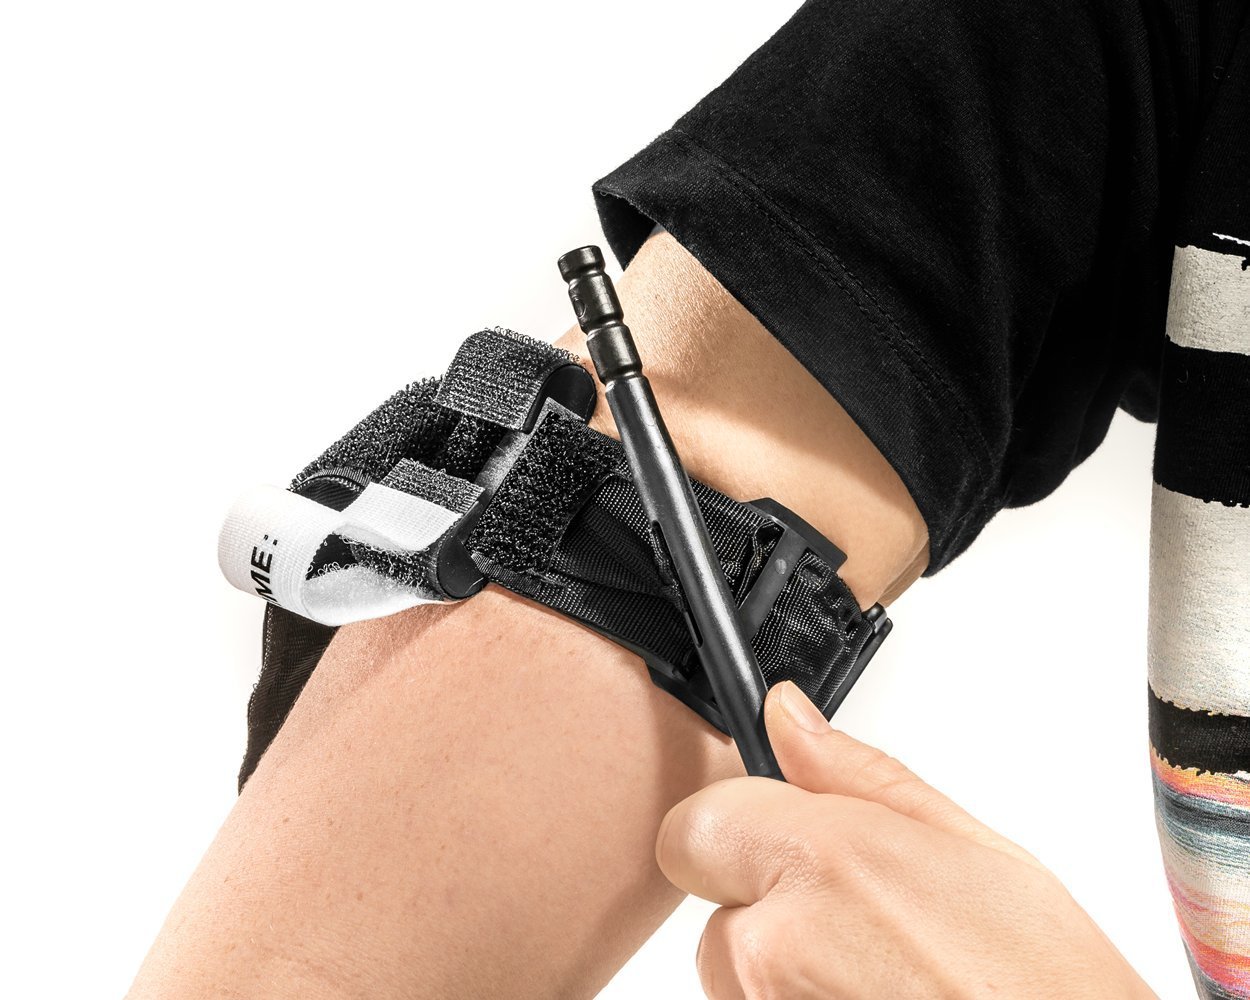
Masywny krwotok z kończyny potrafi zabić w kilka minut - szybciej, niż dojedzie karetka. Staza taktyczna (opaska uciskowa) zakładana wysoko na kończynie i mocno, do zatrzymania krwawienia, kupuje ten czas. Zapisz godzinę założenia (na stazie jest na to miejsce) i przekaż ją ratownikom. Staza boli - i ma boleć; nie zdejmuj jej do przyjazdu pomocy.
Jedna uwaga: staza to narzędzie, którego warto nauczyć się używać, zanim będzie potrzebne. Każde szkolenie z pierwszej pomocy z modułem urazowym to czas zainwestowany w czyjeś życie.